加入社区
 核心功能
让模型更易用,让创作更自由
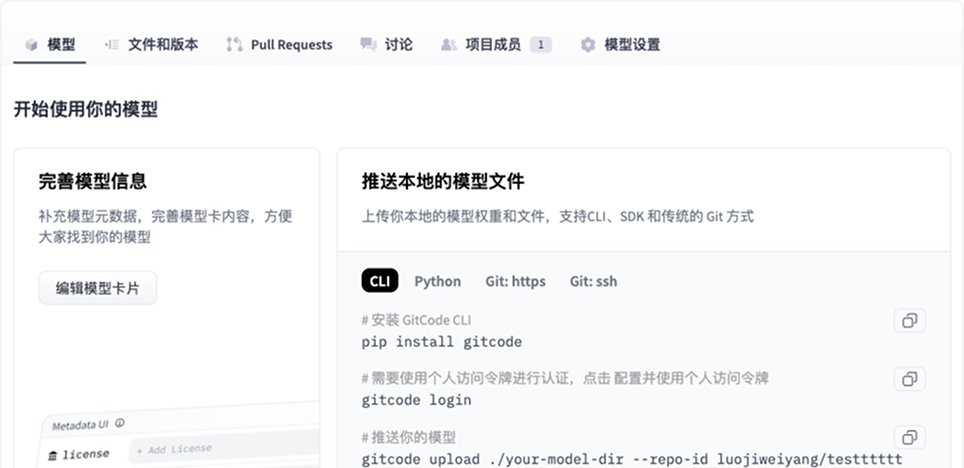
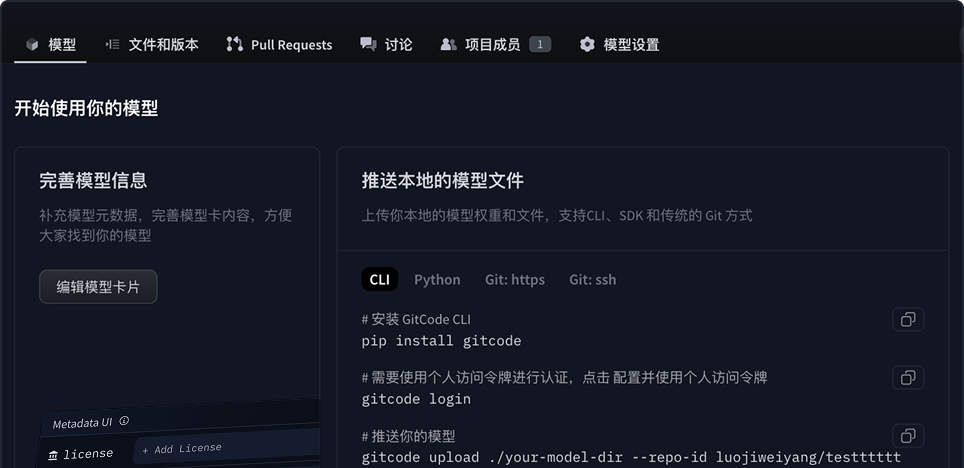
模型托管
安全托管,轻松版本化,让模型像代码一样流动
模型/数据集加速
全球分发,瞬间加载,让下载等待成为过去式,专注创新
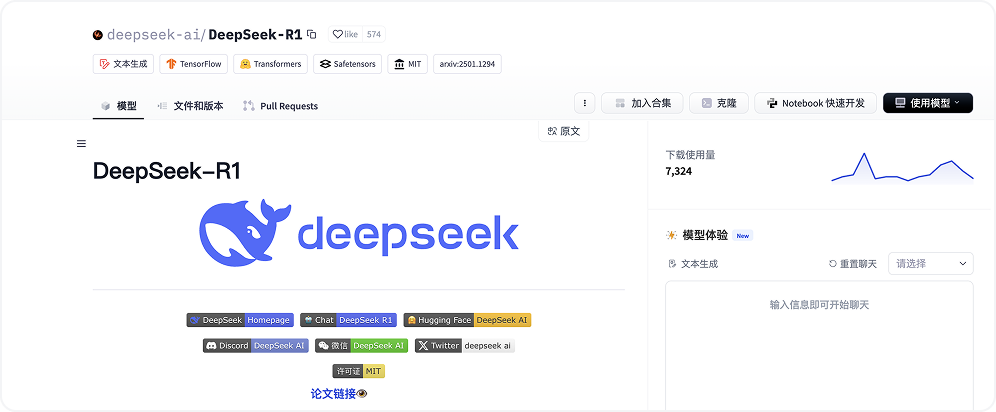
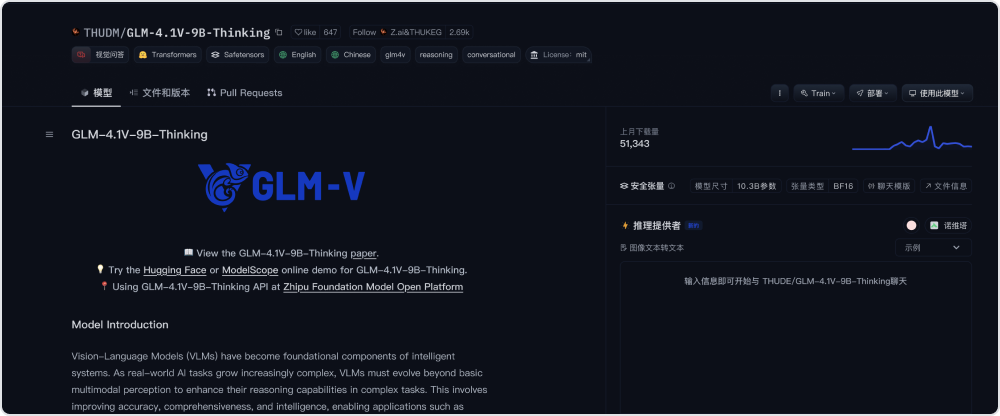
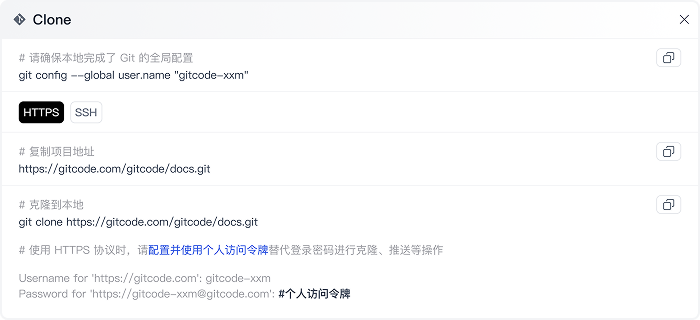
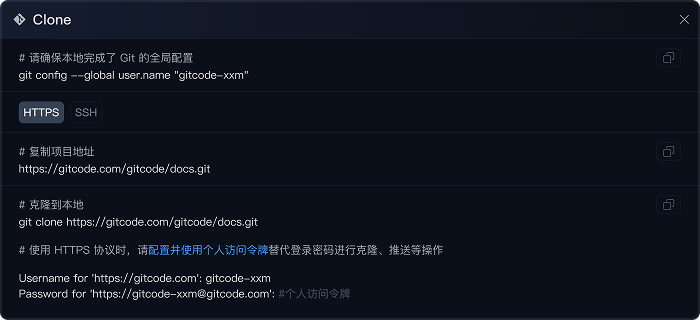
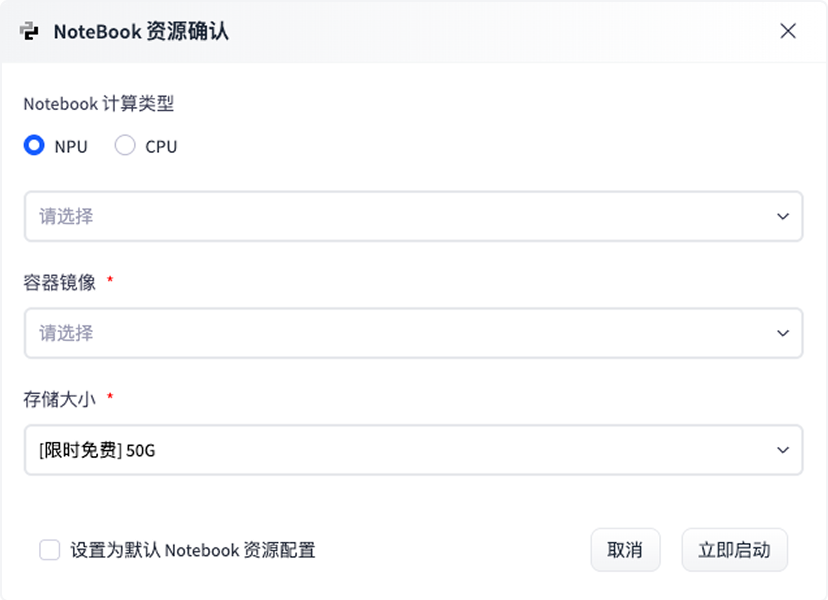
开发者个人工作台
一站式管理与展示,让 AI 创作更有序、更出彩
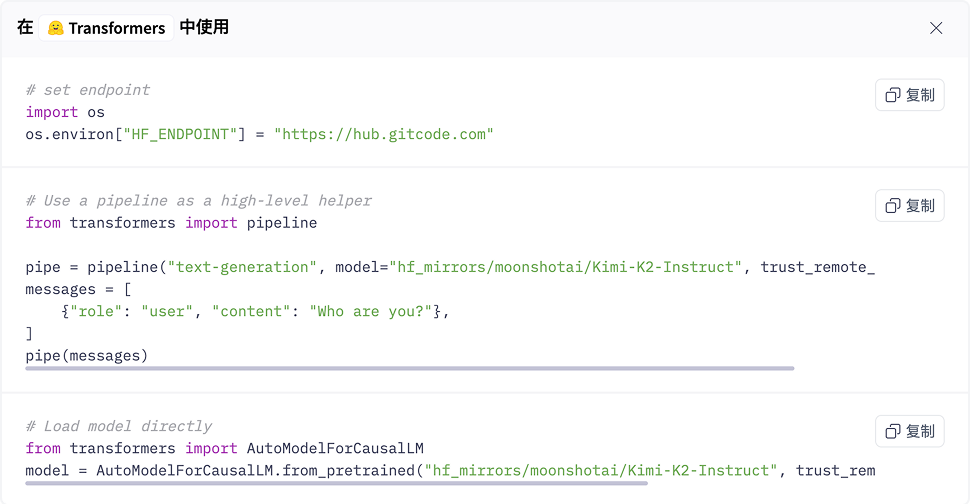
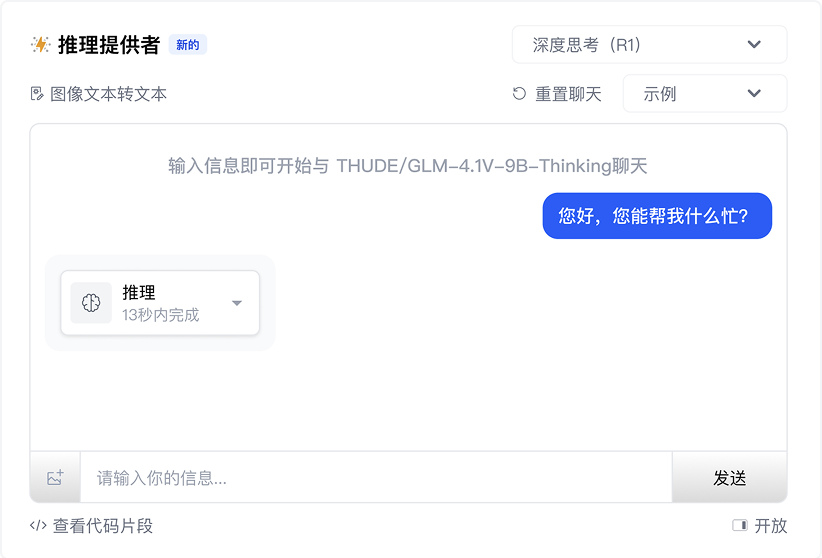
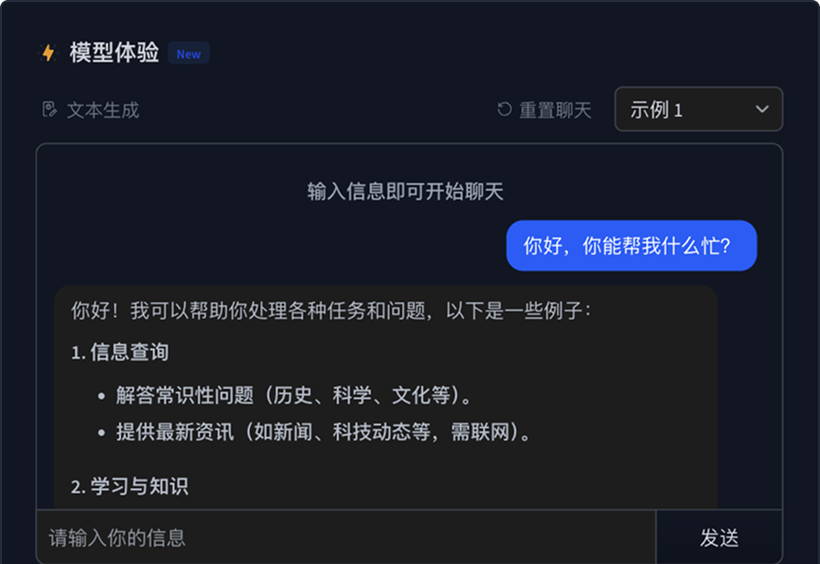
模型使用
多样化体验方式,随时随地解锁 AI 能力

社区活动
活力四射的开发者社区,挑战赛、协作项目与开放交流,让创意在共创中走向世界
 核心功能
让模型更易用,让创作更自由
模型托管
安全托管,轻松版本化,让模型像代码一样流动
模型/数据集加速
全球分发,瞬间加载,让下载等待成为过去式,专注创新
开发者个人工作台
一站式管理与展示,让 AI 创作更有序、更出彩
模型使用
多样化体验方式,随时随地解锁 AI 能力
社区活动
活力四射的开发者社区,挑战赛、协作项目与开放交流,让创意在共创中走向世界
 热门推荐
发现、分享、部署最先进的AI模型、数据集和应用
MiniCPM5-2B
MiniCPM5-2B 是一款面向端侧、本地部署和资源受限场景的 2B 稠密 Transformer,能够达到同尺寸开源模型 SOTA 水平。
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash 是一个多模态混合专家(MoE)模型,拥有 5520 亿骨干参数,并支持最多一百万 token 的上下文长度。该模型原生支持图像和文本输入,并以自回归方式生成文本
Qwen3.8-27B
可处理多步复杂任务,支持图像与长视频理解,提供灵活思考控制与深度可调推理,适配主流开发工具链,适用于编码、专业工作及科研场景,部署友好且支持百万级上下文。
Edge0-35B-A3B-preview
适用于 Apple Silicon 本地聊天、推理与 OpenAI 兼容服务。35B 稀疏 MoE 4-bit 预览模型,采用 SSD 专家流式卸载、预路由与 LoRA 恢复,激活内存低于 3 GiB,解码约 15 tok/s,开箱即用。
Atria-Dawn-Preview
可用于科研实验、软件创作、报告交付和授权安全测试等端到端智能体任务。基于744B MoE GLM-5.2,支持256K上下文、工具调用与多步执行,提供Instruct与FP8权重,支持本地部署和在线访问。